效果示例
Doc2X 网页版现有的翻译效果:逐段译文,以及保留版式的译文 PDF。翻译 API 基于同一套解析与翻译能力,正在开发中。
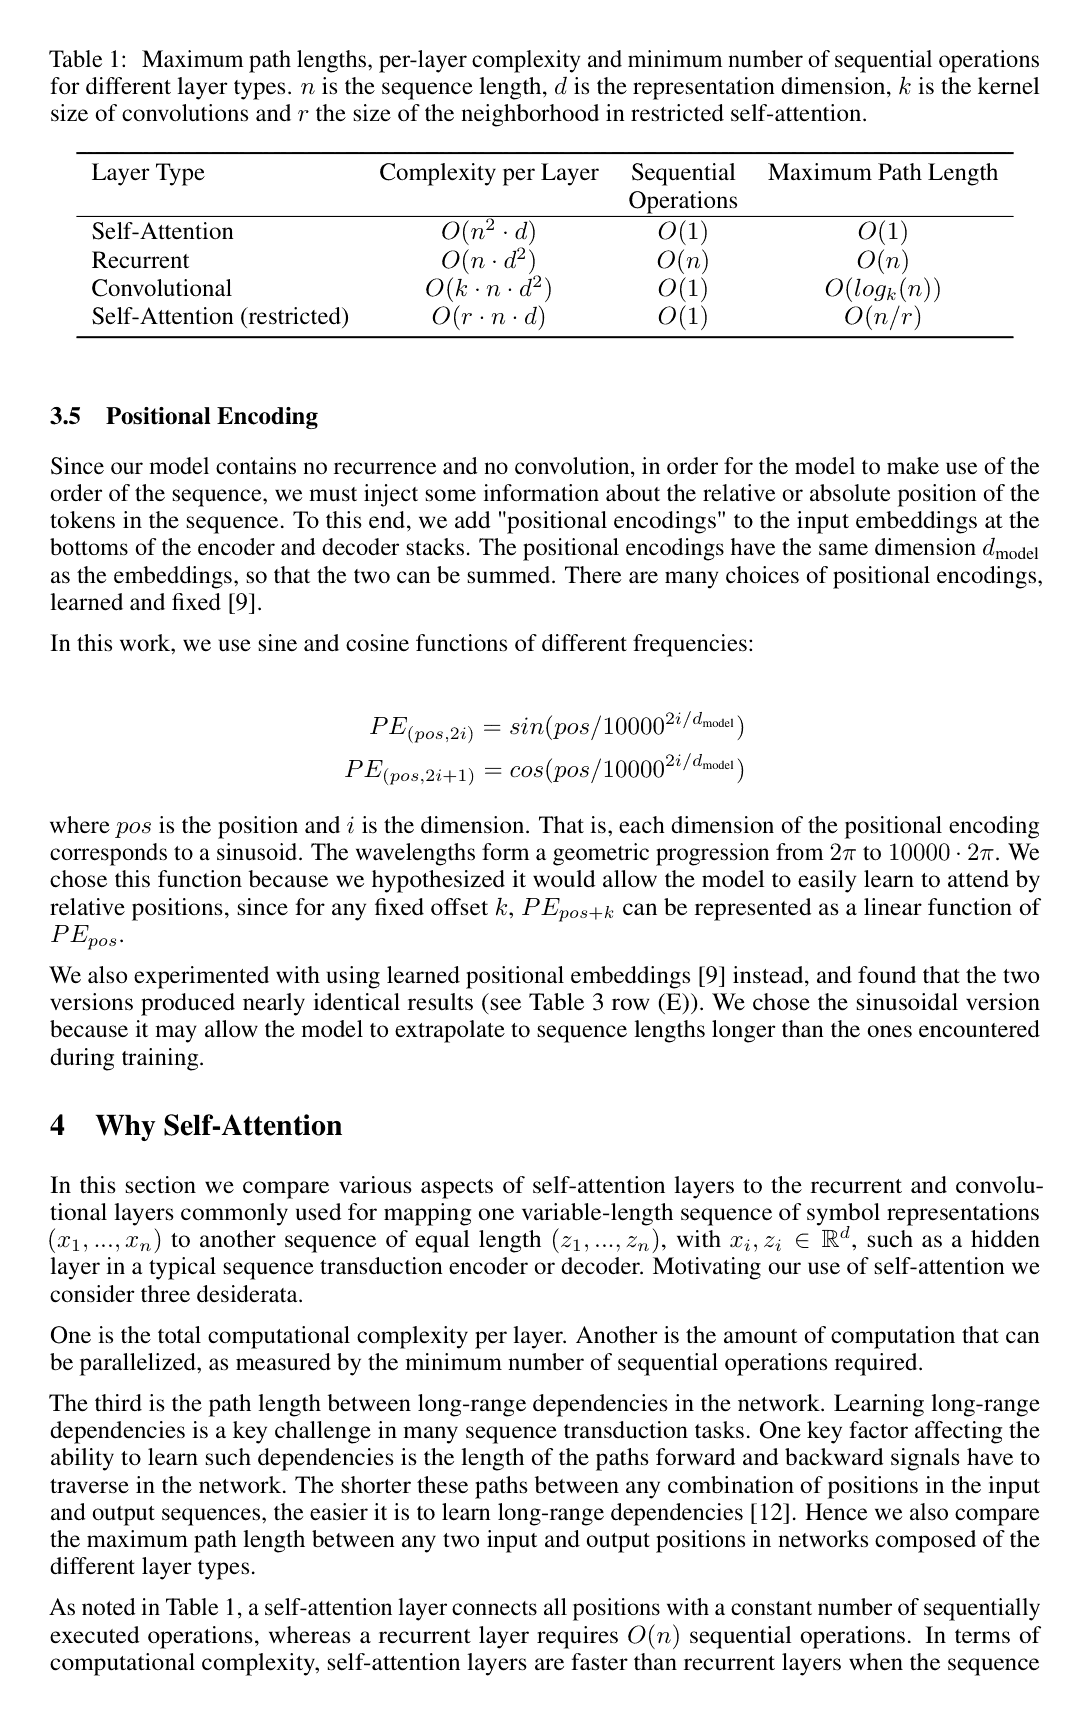
- 图注
- 表格
- 标题
- 正文
- 公式
表 1:不同层类型的最大路径长度、每层复杂度和最小顺序操作数。
|
层类型 |
每层复杂度 |
顺序操作 |
最大路径长度 |
|
自注意力机制 |
|
|
|
|
循环 |
|
|
|
|
卷积 |
|
|
|
|
自注意力机制(受限) |
|
|
|
3.5 位置编码
由于我们的模型既不包含循环结构也不包含卷积结构,为了让模型能够利用序列的顺序信息,我们必须注入一些关于序列中词元相对位置或绝对位置的信息。为此,我们在编码器和解码器堆栈底部的输入嵌入中添加“位置编码”。位置编码与嵌入的维度相同,均为
在这项工作中,我们使用不同频率的正弦和余弦函数:
其中 pos 是位置,
我们还尝试了使用可学习的位置嵌入 [9] 进行替代,发现这两种版本产生的结果几乎相同(见表 3 行 (E))。我们选择正弦版本是因为它可能使模型能够外推到比训练期间遇到的序列更长的长度。
4 为何使用自注意力机制
在本节中,我们将自注意力层的各个方面与常用于将一个可变长度的符号表示序列
一是每层的总计算复杂度。另一个是可并行化的计算量,通过所需的最小顺序操作数来衡量。
第三个是网络中长距离依赖关系之间的路径长度。学习长距离依赖关系是许多序列转换任务中的关键挑战。影响学习此类依赖关系能力的一个关键因素是前向和后向信号在网络中必须经过的路径长度。输入和输出序列中任意位置组合之间的这些路径越短,就越容易学习长距离依赖关系 [12]。因此,我们还比较了由不同层类型组成的网络中任意两个输入和输出位置之间的最大路径长度。
如表 1 所示,自注意力层通过固定数量的顺序执行操作连接所有位置,而循环层需要
网页版现有的翻译结果,翻译 API 即将上线
原文 PDF
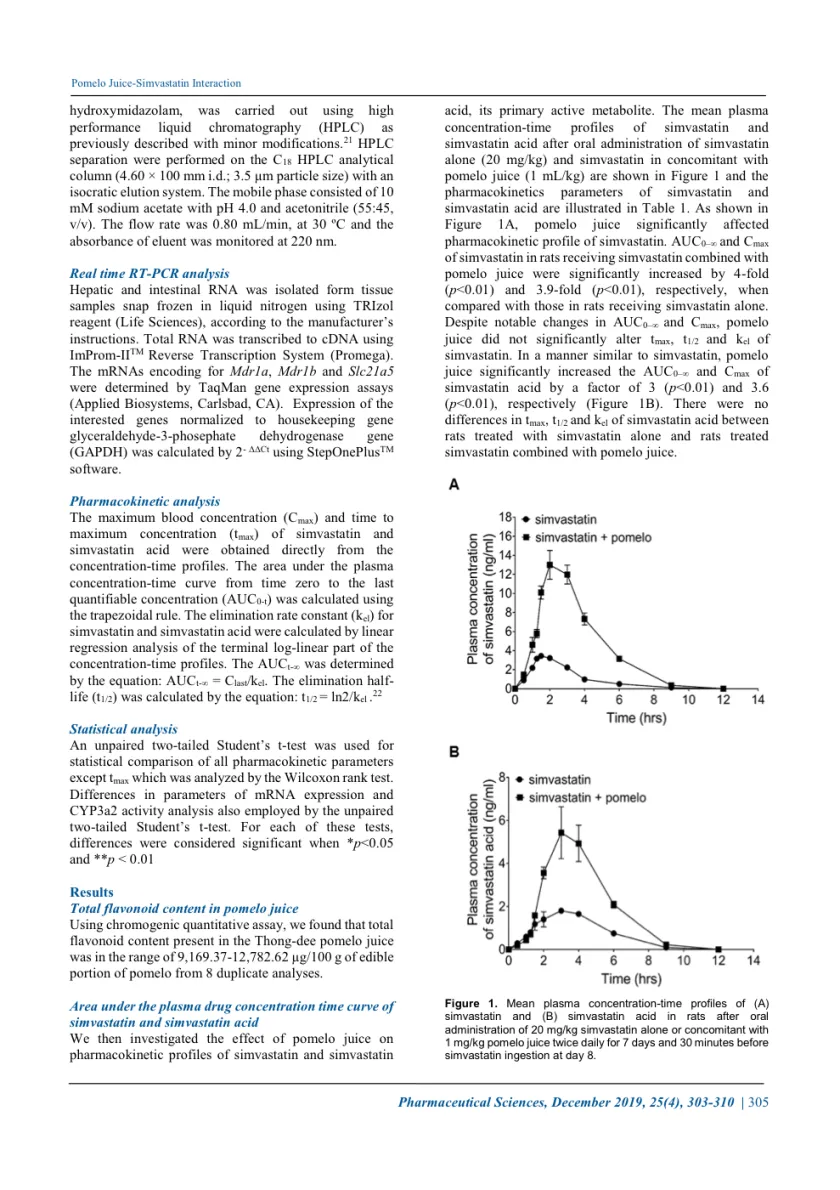
保留版式的译文 PDF(网页版现有效果)
能力说明
- 先解析再翻译
- 版面、公式、表格先被准确识别,翻译只作用在文字上,公式和图表不被破坏。
- 保留版式输出
- 目标是生成与原文版式接近的译文文档,并支持双语对照。
- 与解析共用接入方式
- 沿用同一套 API Key、任务与轮询方式,已接入解析的系统改动很小。
适用场景
论文与技术文档
外文论文、芯片手册、API 文档整篇翻译,公式和代码保持原样。
出海与本地化
产品说明书、合同等文档批量翻译,减少人工排版。
预约内测
说明你的业务场景、文档类型和预计用量,上线后优先邀请你试用。
常见问题
PDF 文档翻译 API什么时候上线?
正在开发中,上线后会在能力中心和控制台通知。现在可以通过页面上的“预约内测”联系我们,说明场景和预计用量,我们会优先邀请。
PDF 文档翻译 API上线前,先聊聊你的场景
告诉我们你的业务场景和预计用量,上线后优先邀请内测。