Doc2X 文档解析 API复杂文档,一次解析到位
公式输出 LaTeX,表格输出 HTML,多栏版面按阅读顺序还原。把 PDF 和图片变成大模型、知识库和业务系统能直接使用的 Markdown 与 JSON。
- 图注
- 表格
- 标题
- 正文
- 公式
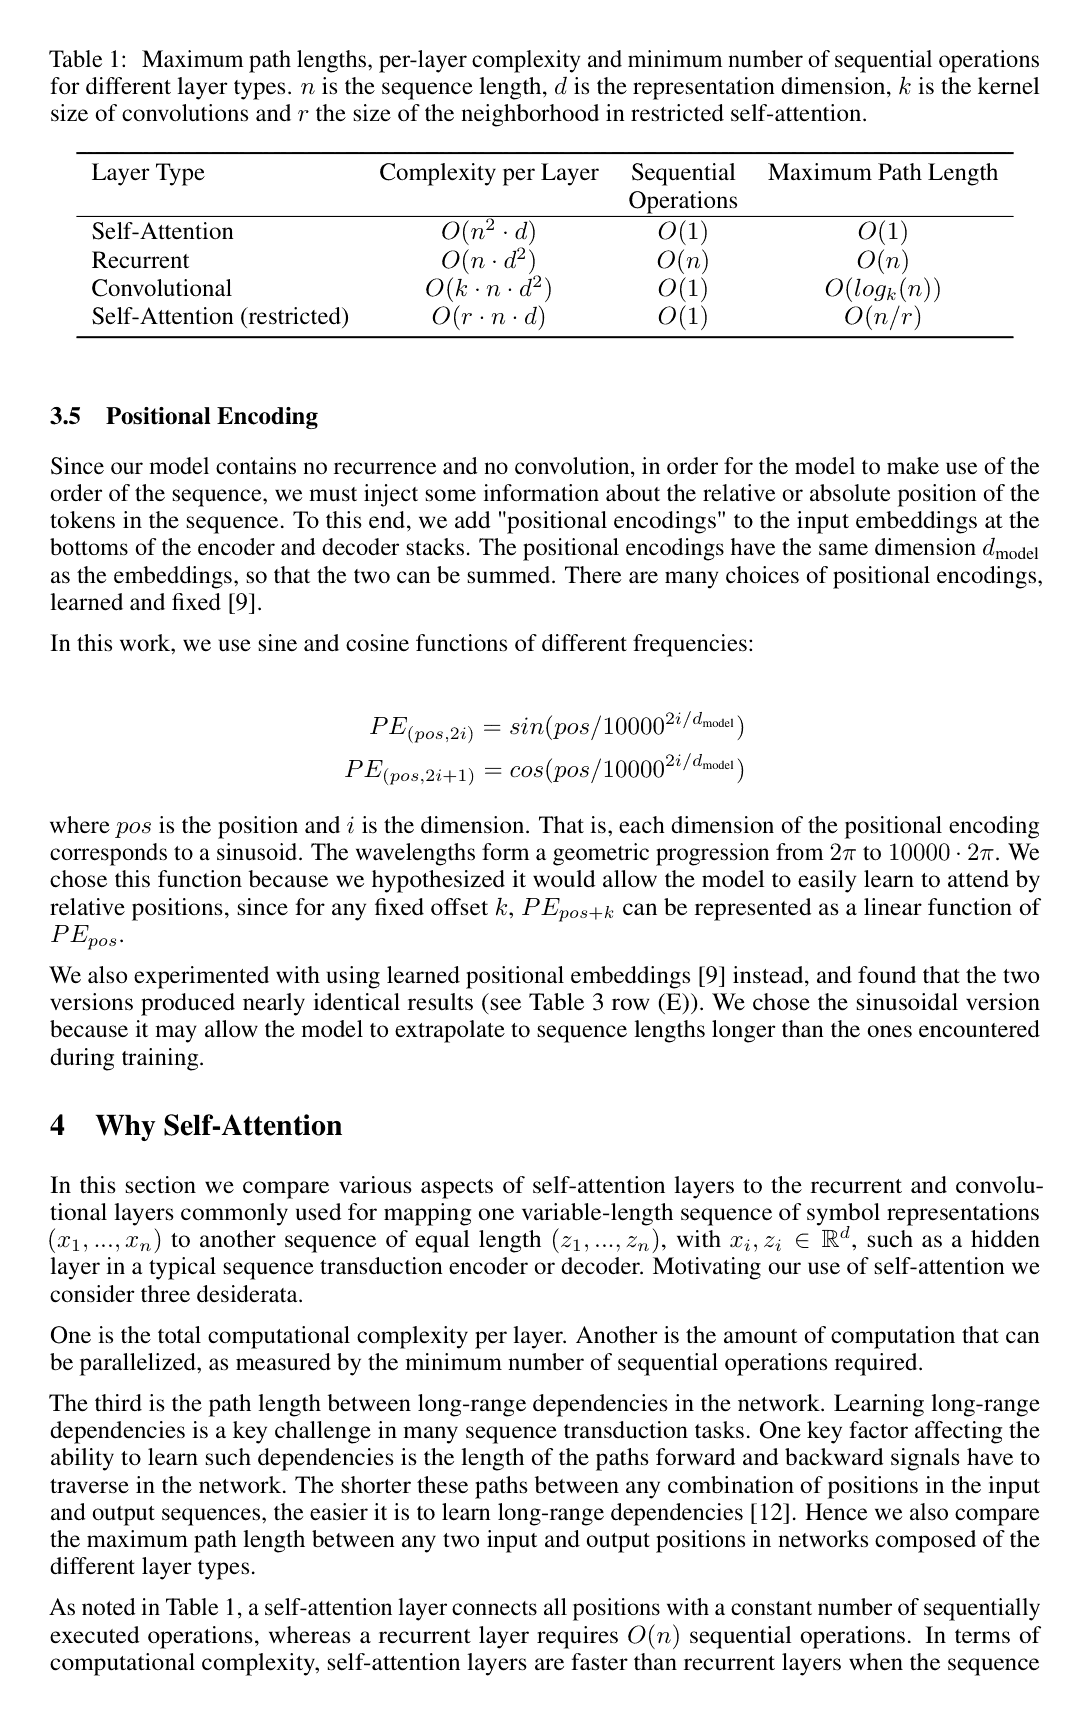
Table 1: Maximum path lengths, per-layer complexity and minimum number of sequential operations for different layer types.
|
Layer Type |
Complexity per Layer |
Sequential Operations |
Maximum Path Length |
|
Self-Attention |
|
|
|
|
Recurrent |
|
|
|
|
Convolutional |
|
|
|
|
Self-Attention (restricted) |
|
|
|
3.5 Positional Encoding
Since our model contains no recurrence and no convolution, in order for the model to make use of the order of the sequence, we must inject some information about the relative or absolute position of the tokens in the sequence. To this end, we add "positional encodings" to the input embeddings at the bottoms of the encoder and decoder stacks. The positional encodings have the same dimension
In this work, we use sine and cosine functions of different frequencies:
where pos is the position and
We also experimented with using learned positional embeddings [9] instead, and found that the two versions produced nearly identical results (see Table 3 row (E)). We chose the sinusoidal version because it may allow the model to extrapolate to sequence lengths longer than the ones encountered during training.
4 Why Self-Attention
In this section we compare various aspects of self-attention layers to the recurrent and convolutional layers commonly used for mapping one variable-length sequence of symbol representations
One is the total computational complexity per layer. Another is the amount of computation that can be parallelized, as measured by the minimum number of sequential operations required.
The third is the path length between long-range dependencies in the network. Learning long-range dependencies is a key challenge in many sequence transduction tasks. One key factor affecting the ability to learn such dependencies is the length of the paths forward and backward signals have to traverse in the network. The shorter these paths between any combination of positions in the input and output sequences, the easier it is to learn long-range dependencies [12]. Hence we also compare the maximum path length between any two input and output positions in networks composed of the different layer types.
As noted in Table 1, a self-attention layer connects all positions with a constant number of sequentially executed operations,whereas a recurrent layer requires
渲染 SDK 输出,与网页版、控制台看到的效果一致
一个 API Key,调用全部能力
文档解析与格式转换已上线;文档翻译与图像处理优先开放,现在可以预约内测。
PDF 解析 API
PDF 转 Markdown / JSON,公式、表格、多栏版面一次还原
保留版式 PDF 转 Word API
页面尺寸和图文位置与原 PDF 一致,文字与公式仍可编辑
3.5 Positional Encoding
3.5 位置编码
In this work, we use sine and cosine functions of different frequencies:
在这项工作中,我们使用不同频率的正弦和余弦函数:
双语对照翻译 API
原文与译文逐段对照,公式与表格保持原样
 原图
 高清化后
图片高清化 API
模糊、带噪点的插图与截图,恢复成矢量般清晰的高清图
 带作答与批改的原卷
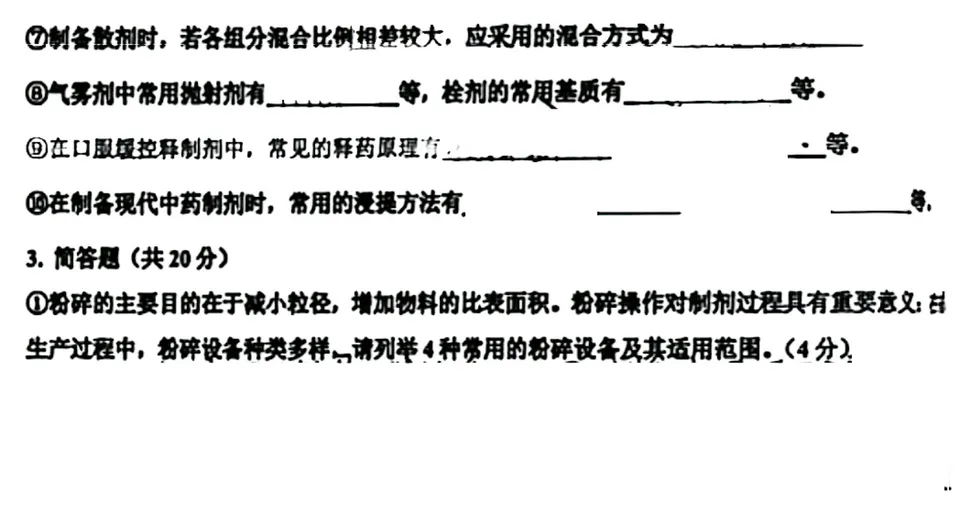 去手写后
手写擦除 API
擦掉试卷和作业上的手写笔迹,保留印刷内容
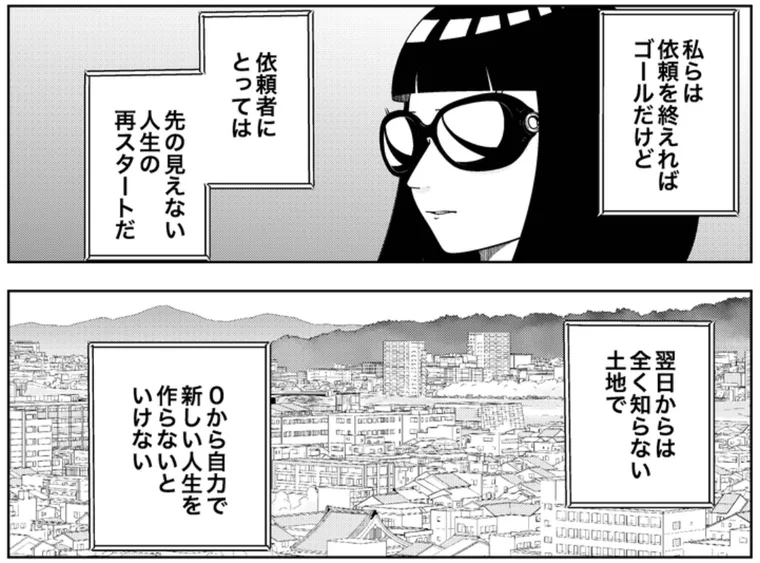 日文原图
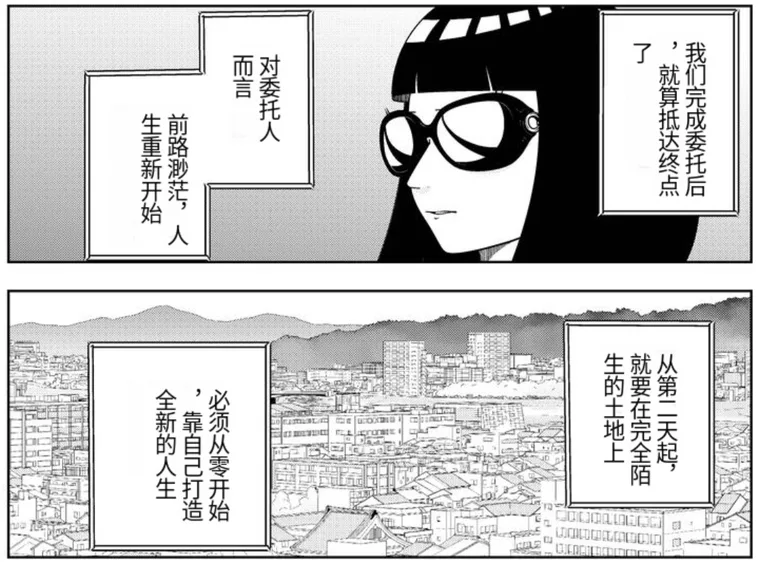 中文译图
图片翻译 API
识别图片中的文字,翻译后回填到原位置
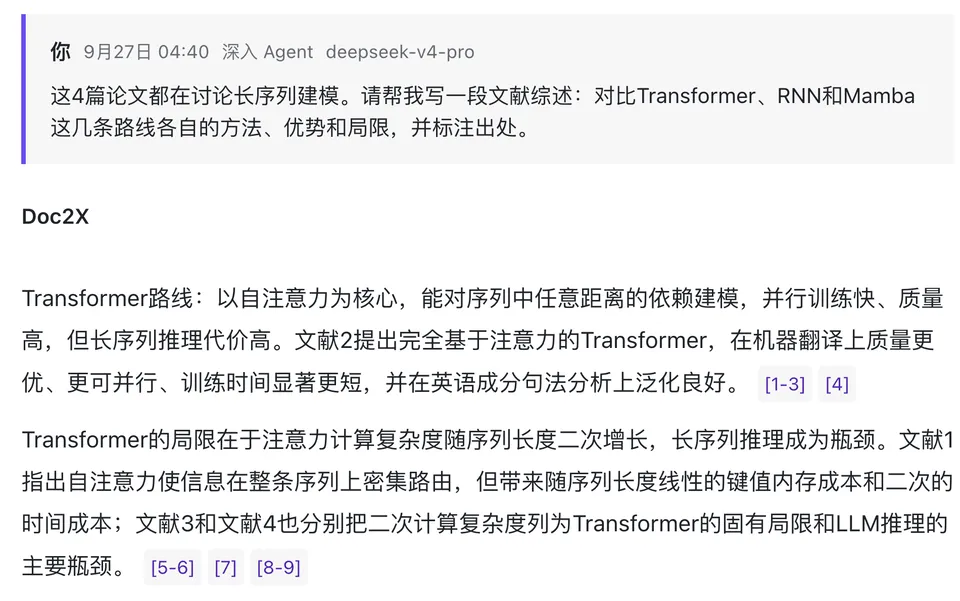
多文档知识库 API
多份文档一起提问,跨文档比较观点,回答附原文出处
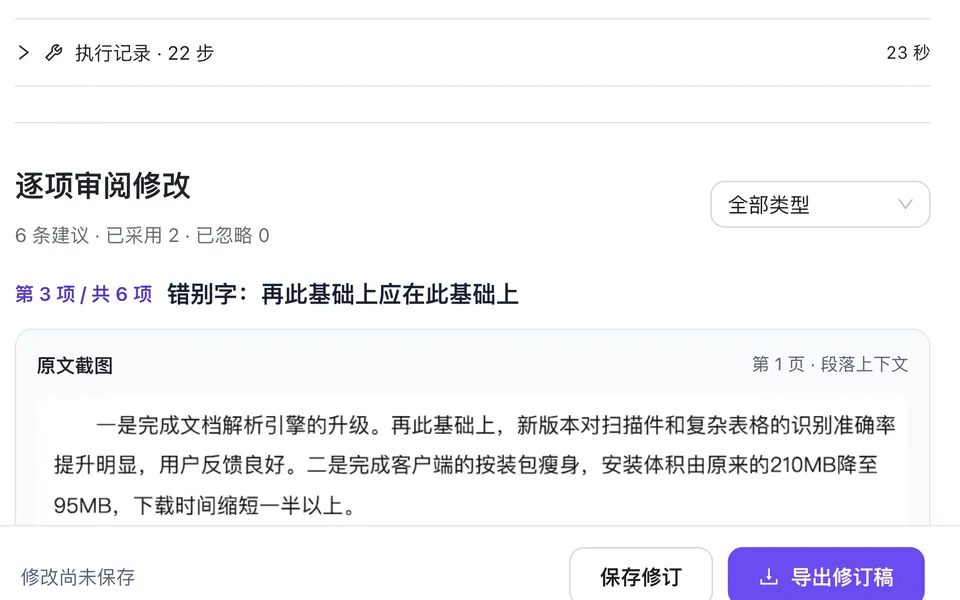
AI 校对 API
检查文字、公式与结构,逐项给出有原文依据的修改建议
语音识别 API(气声增强)
轻声、气声也能准确转写,安静场合压低声音照样输入
优先开放:文档翻译与图像处理
这些能力已经在 Doc2X 网页版和插件里使用,正陆续开放为 API。现在预约内测,上线后优先邀请。
PDF 文档翻译 API
基于 Doc2X 解析的整篇翻译:段落、公式和图表留在原来的位置,面向论文、手册、合同等需要保留版式的文档;也可以逐段输出双语对照。
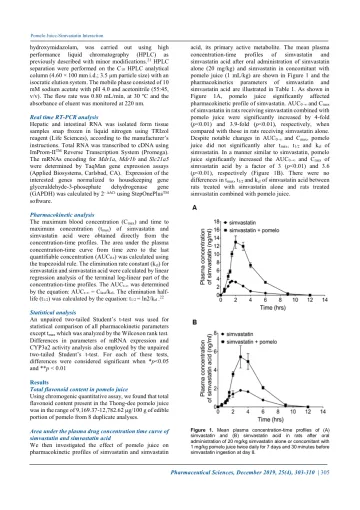
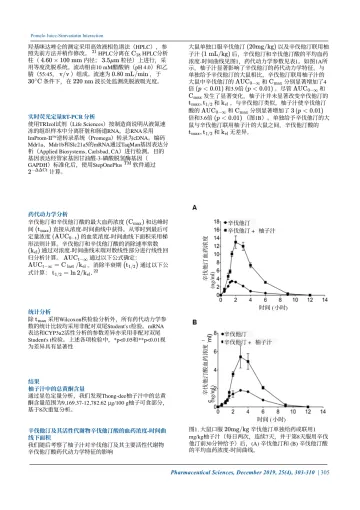
双语对照(网页版现有效果,公式由渲染 SDK 排版)
3.5 Positional Encoding
3.5 位置编码
In this work, we use sine and cosine functions of different frequencies:
在这项工作中,我们使用不同频率的正弦和余弦函数:
where pos is the position and
其中 pos 是位置,
原图高清化后图像处理 API
面向文档与教育场景,处理后的图片可以直接进入解析、题库或排版流程。
- 手写擦除擦掉试卷和作业上的手写笔迹,保留印刷内容
- 去水印去掉扫描件和截图上的水印文字,正文与公式保持原样
- 图像区域擦除去掉选定区域的文字或杂物,自动补全背景
- 图片高清化模糊、带噪点的插图与截图,恢复成矢量般清晰的高清图
- 文档图像增强拍照文档切边、矫正与增强
细到每一个版面块
v3-2026 模型在逐页 Markdown 之外返回结构化版面块:9 种基础块与 8 种分组容器,每块带类型、坐标、阅读顺序和父子关系,可以直接用于 RAG 切分、版面重排与溯源。
- 标题
Title文档标题与各级章节标题 - 正文
Text按阅读顺序排列的段落 - 公式
Equation独立公式,输出 LaTeX - 公式编号
EquationNumber如 (1)、(2),与公式对应 - 表格
Table输出 HTML,保留合并单元格 - 图片
Figure裁切后的插图地址 - 图注
Caption图注、表注与补充说明 - 代码块
Code代码或伪代码本体 - 下划线
Underline单独识别出的下划线元素 - 公式组
EquationGroup多行公式与公式编号 - 表组
TableGroup表格与表注 - 图组
FigureGroup图片与图注 - 代码组
CodeGroup代码块与说明文字 - 目录
TOCGroup目录条目与对应页码 - 脚注
FootnoteGroup页面底部的脚注区域 - 参考文献
ReferenceGroup文末的参考文献列表 - 侧栏
SideGroup侧栏、旁注区域 - 页眉页脚
is_boilerplate页眉、页脚、页码标记为样板文字
为难解析的文档而生
理工科论文、试卷、研报这类公式和表格密集的文档,正是 Doc2X 最擅长的场景。
公式:LaTeX,可编辑
行内与独立公式分别标记;导出 Word 后仍是可编辑的公式,不是图片。
表格:HTML,跨页可合并
保留表头与合并单元格,单元格里的公式同样输出 LaTeX;导出时可合并跨页表格。
版面:按阅读顺序还原
多栏排版、图文混排、页眉页脚都按阅读顺序处理,v3-2026 模型额外给出父子关系。
扫描件与拍照文档
扫描版 PDF、手机拍照、截图都能识别,和电子版一样输出结构化结果。
插图自动裁切
图片块带裁切后的图片地址,图注、表注单独成块,方便重排和入库。
一次解析,多种导出
同一个任务可以导出 Markdown、Word、LaTeX,不需要重新上传文件。
一次解析,导出 11 种格式
Word、Markdown、LaTeX 已开放 API;保留 PDF 版式的 Word、WPS、MathType、可搜索 PDF、Typst、HTML、Excel、Eduediter 已在网页版上线,正陆续开放到 API。
保留 PDF 版式的 Word
页面尺寸和图文位置与原 PDF 一致,文字和公式仍可编辑。试卷、合同、论文这类版面要紧的文档,转成 Word 后不用重新排版。
- 页面尺寸不变
- 段落、图片、表格停在原位
- 文字与公式仍可编辑
- Word流式排版,公式为可编辑的 Word 公式API 已开放
- 保留 PDF 版式的 Word页面尺寸和图文位置不变,文字与公式仍可编辑网页版已上线 · API 即将开放
- Markdown可选 $ 风格公式,适合入库与 RAGAPI 已开放
- LaTeX公式、表格保留为 LaTeX 源码API 已开放
- WPS(可编辑公式)在 WPS 里继续编辑文字、表格与公式网页版已上线 · API 即将开放
- Word MathType公式为 MathType 对象,适合 MathType 工作流网页版已上线 · API 即将开放
- 可搜索 PDF扫描 PDF 添加文本层,可搜索、选中、复制网页版已上线 · API 即将开放
- Typst带入 Typst 继续专业排版网页版已上线 · API 即将开放
- HTML网页发布与在线预览网页版已上线 · API 即将开放
- 表格 Excel把文档里的表格导出为 Excel网页版已上线 · API 即将开放
- Eduediter导出 WSD 文档,继续编辑文字与公式网页版已上线 · API 即将开放
网页版另提供“导出到 MD 编辑器”“复制全文 Markdown”等页面内操作。
三种方式接入,几分钟跑通
在请求头加入 API Key 即可调用,同一个 Key 适用于全部已上线的能力。
# 1. 申请上传地址(model 可选 v2 或 v3-2026)
curl -X POST 'https://v2.doc2x.noedgeai.com/api/v2/parse/preupload' \
  -H 'Authorization: Bearer sk-xxx' \
  -H 'Content-Type: application/json' \
  -d '{"model": "v3-2026"}'

# 2. 用返回的 url 上传文件
curl -X PUT "<url>" --data-binary @paper.pdf

# 3. 轮询结果,success 后读取逐页 Markdown
curl 'https://v2.doc2x.noedgeai.com/api/v2/parse/status?uid=<uid>' \
  -H 'Authorization: Bearer sk-xxx'
用在哪些业务里
大模型与知识库
制度文件、产品手册、研报解析成干净的 Markdown,按标题和版面块切分入库,RAG 检索噪声更少。
版面分析 API科研与出版
论文、教材里的公式、表格、参考文献完整保留,可再导出 Word 或 LaTeX 继续编辑。
PDF 解析 API教育与题库
试卷和教辅批量转成带公式的结构化文本;试卷切题、题目答案配对正在开放为 API。
教育 AI 能力金融与研报
研报、年报里的数据表抽成 HTML,再转成表格或写入数据库。
表格识别 API文档翻译
论文、手册、合同整篇翻译并保留版式;图片翻译可把译文回填到原位置。
文档翻译 API你的场景不在这里?
告诉我们文档类型和预计用量,我们用你的样例文档实测,再给出接入方案。
联系商务按页计费,用多少买多少
1 张图片按 1 页计算。资源包买得越多单价越低,最低 ¥0.01/页;也可以充值余额按量扣费。
- 最省的买法
- ¥540 资源包 + ¥200 资源包 × 2共 50,000 页
- 合计
- ¥940折合 ¥0.0188/页
按当前资源包价目估算,以控制台购买页为准;用量不稳定也可以充值余额按量扣费。
面向企业的接入方式
大批量处理、定制输出结构或有部署要求的团队,可以直接和我们沟通方案。
- 私有化部署
- 对数据有本地化要求的团队,可按规模与场景沟通部署方式。
- 对公结算与发票
- 支持对公转账,已支付订单可申请增值税专用发票或普通发票。
- 专人技术支持
- 接入时的参数选择、异常排查与结果后处理,有工程师协助。
- 解析结果短期保存
- 解析结果只临时保存 24 小时,请在任务完成后及时取回。
你要的是 API,还是在线使用?
开放平台和 Doc2X 会员是两套额度,互不通用。个人在线解析、翻译,请直接去 Doc2X 网页版开通会员。
| Doc2X 开放平台本站 | Doc2X 网页版 / 会员个人在线使用 | |
|---|---|---|
| 适合谁 | 开发者和企业,把能力接进自己的程序、网站或系统 | 个人,打开网页或客户端直接使用 |
| 怎么用 | 创建 API Key,通过接口、MCP 或 SDK 调用 | 上传文件即可解析、翻译、导出,不用写代码 |
| 怎么计费 | 按解析页数,资源包或余额 | 会员套餐与加量包 |
| 在哪购买 | 开放平台控制台“购买 API 额度” | doc2x.noedgeai.com 会员页 |
| 额度能用在 | 只用于 API 调用 | 网页版、电脑客户端、Zotero 插件、doc2x-cli |
| 获取 API Key | 去开通 Doc2X 会员 |
常见问题
开放平台和 Doc2X 会员有什么区别?
开放平台面向开发者和企业:创建 API Key 后在自己的程序里调用接口,按解析页数计费。Doc2X 会员面向个人在线使用:在 doc2x.noedgeai.com 购买,用于Doc2X 网页版、电脑客户端、Zotero 插件和命令行工具 doc2x-cli。两边的额度互不通用。
开放平台买的额度能在网页版、客户端或 Zotero 插件里用吗?
不能。开放平台的资源包和余额只能通过 API Key 调用接口时使用,不会增加Doc2X 网页版、电脑客户端、Zotero 插件和命令行工具 doc2x-cli的额度。如果你只是想在线解析、翻译文档,请在 doc2x.noedgeai.com 开通会员。
怎样开始调用 API?
登录开放平台控制台,在“API Key”页面创建密钥,在请求头加入 Authorization: Bearer sk-xxx 即可调用。新账号可以先用小额资源包或余额测试效果。
支持哪些输入和输出格式?
输入支持 PDF(含扫描版)和 JPG、PNG 图片;输出为逐页 Markdown,选用 v3-2026 模型时额外返回结构化 JSON 版面块,还可以导出 Word(docx)、LaTeX 和 Markdown 文件。
支持对公转账和开发票吗?
支持。在控制台购买时选择“对公充值”并联系客服办理;已支付的订单可以在“账单与开票”中申请增值税专用发票或普通发票。
买错了怎么办?
用微信或支付宝购买的订单,可以在控制台“账单与开票”里申请退款,退款原因选择“买错了/买多了”。资源包只支持整体退款,时限等细则以《退款规则》为准。
开始接入 Doc2X
创建 API Key 即可调用;大批量、定制或私有化需求请联系商务。